티스토리 뷰
보고서 작성 에이전트를 구현하고 있습니다.
먼저 사용되는 데이터 DB는 MS SQL에서 제공하는 AdvancedWorks DB와 인터페이스 로그, 서버로그 자료를 사용합니다.
인터페이스 로그와 서버로그는 데이터셋 생성 파이썬 코드로 임의 생성한 데이터입니다.
각 데이터 테이블의 메타 정보를 json 데이터형으로 저장하였습니다.
사용한 모델은 Anthropic 기준으로 Haiku(fast), Sonnet(balanced), Opus(quality: 추론) 모델로 진행했습니다.
(OpenAI일 경우 사용한 모델 : gpt-5.4-mini(fast), gpt-5.4(balanced), gpt-5.5(quality))
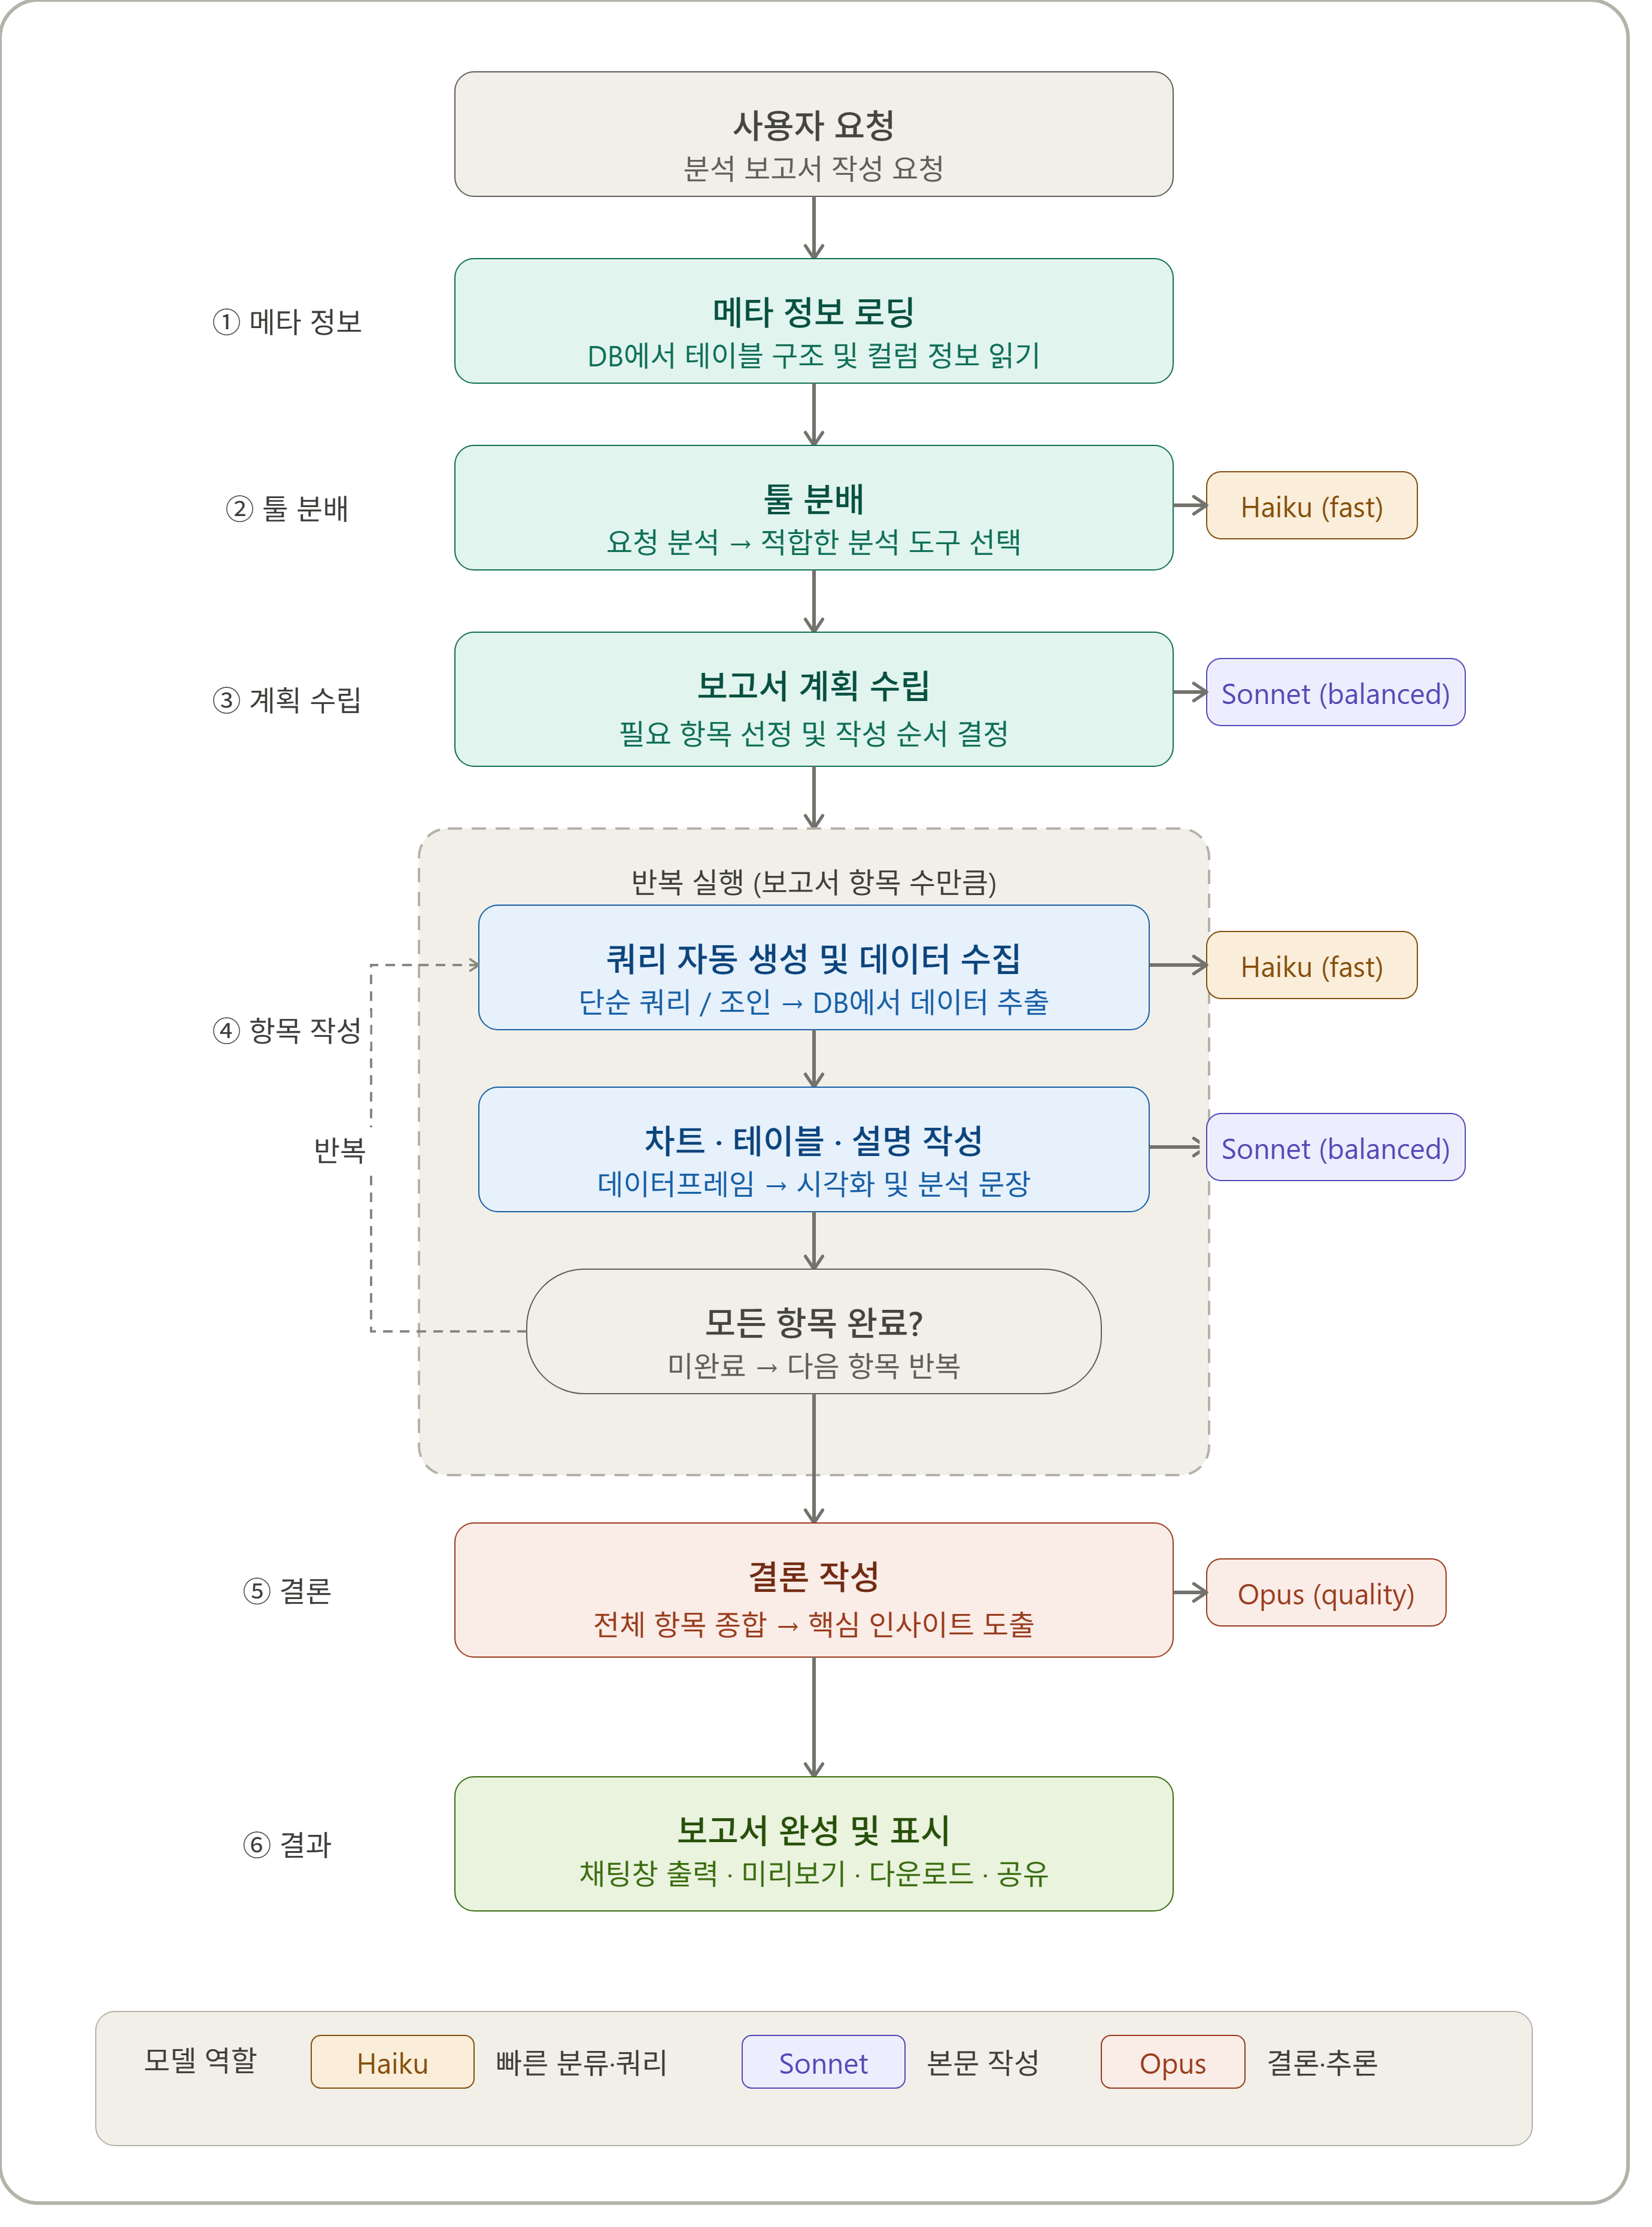
보고서 작성 요청이 들어왔을 때 진행 절차입니다.
1. 메타 정보를 DB에서 읽습니다.
2. 사용자의 요청에 따라 해당 툴에 분배합니다.
- 판매분석보고서 : AdvancedWorks 이용
- 기술분석보고서 : 인터페이스로그 / 서버로그 요청에 따라 해당 DB 이용
3. LLM이 보고서 작성 계획을 수립합니다. - Sonnet / Haiku
- 필요한 항목
- 항목 순서
4. 항목 작성
- 필요 데이터 : 쿼리 자동 생성 툴을 이용하여 데이터 DB에서 쿼리(단순쿼리, 조인)로 데이터를 가져옵니다. - Haiku
- 데이터프레임으로 전환하여 차트, 테이블과 이에 대한 설명 문장을 작성합니다. - Sonnet
- 계획한 모든 항목이 작성될 때까지 반복 수행합니다.
5. 결론 작성 - Opus
- 작성된 항목을 추론 모델에 입력하여 결론을 작성합니다.
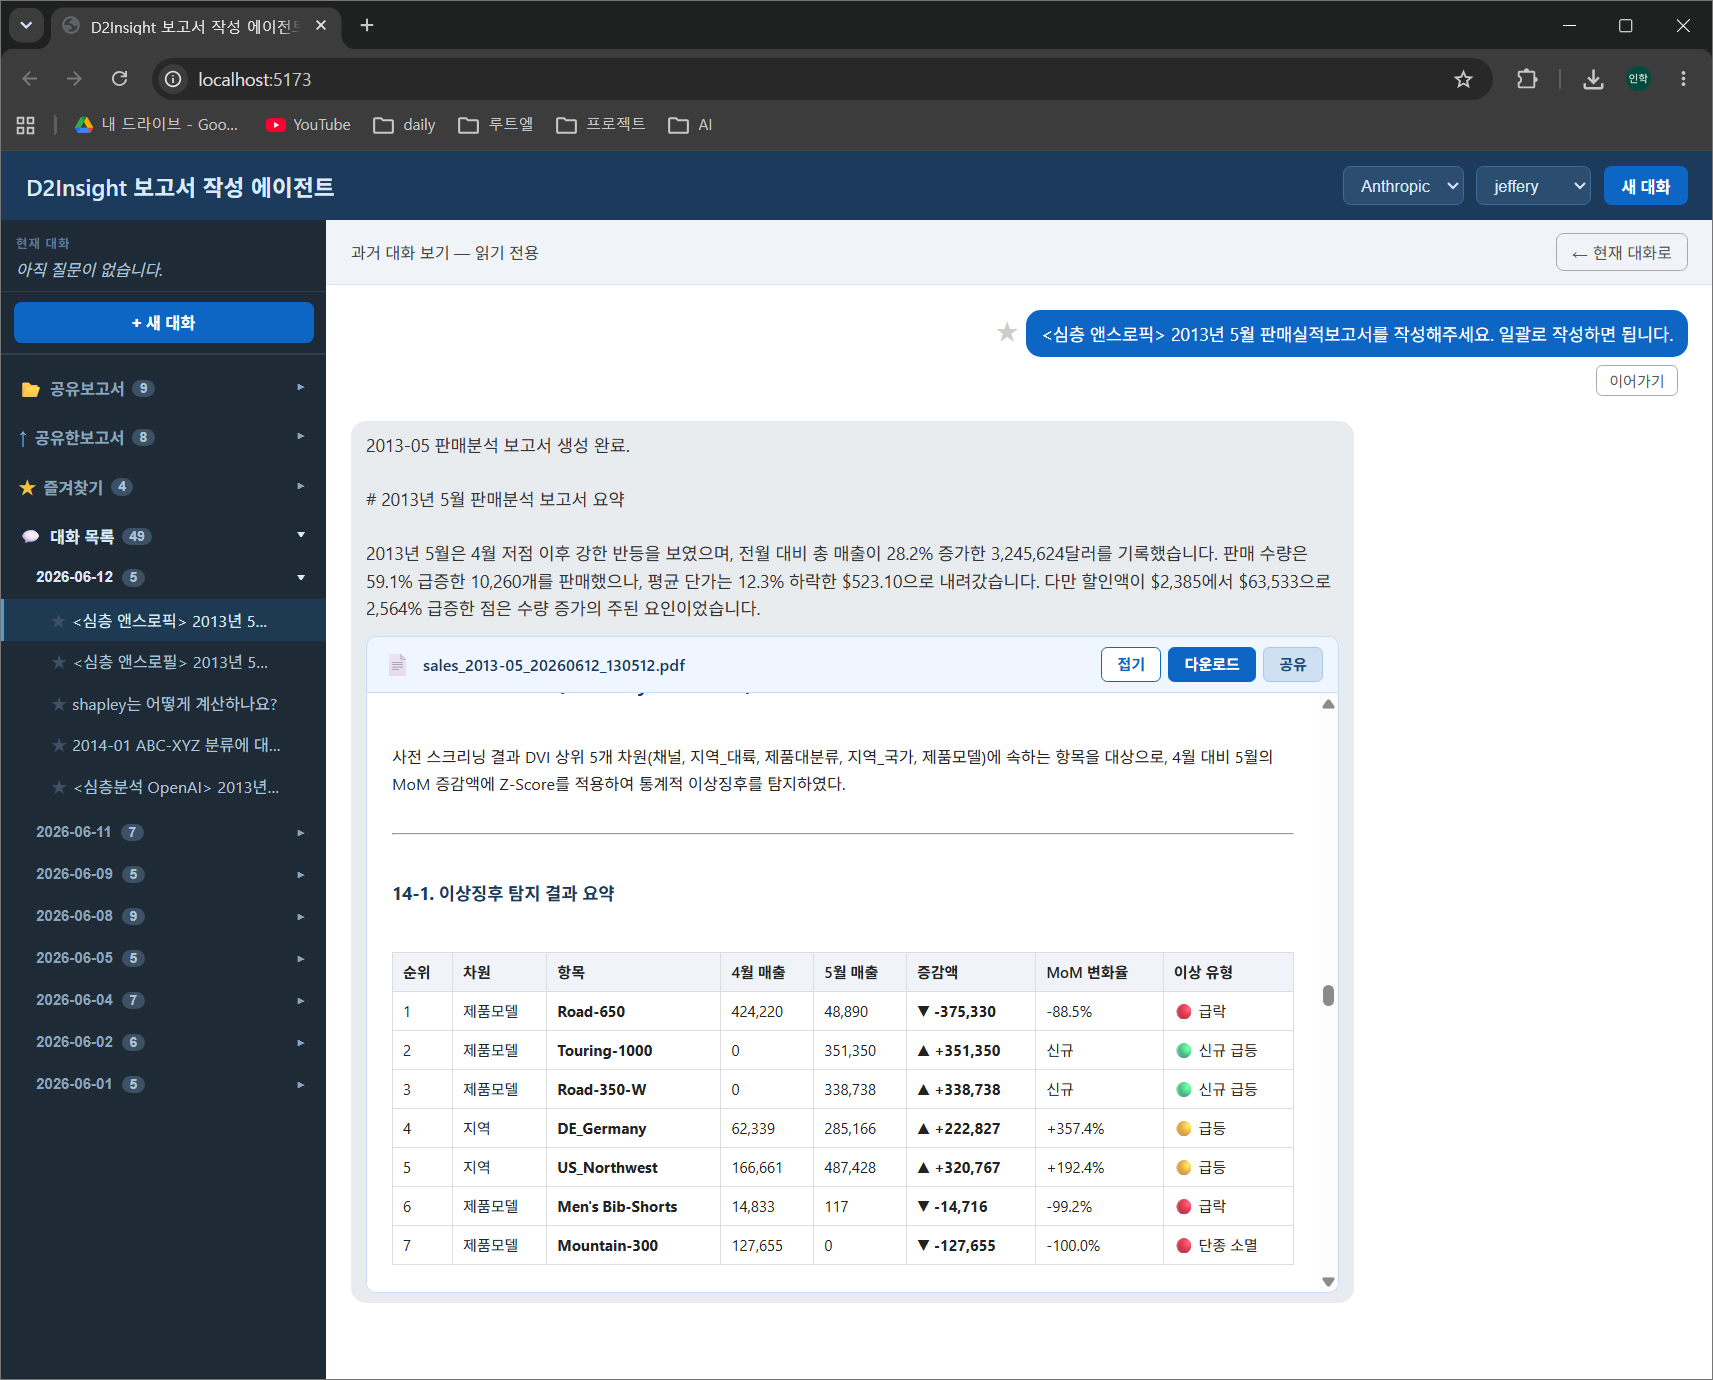
6. 채팅창에 결과를 표시합니다. 미리보기, 다운로드, 공유 버튼으로 이후 동작을 진행합니다.
- 미리보기 : 채팅창 말풍선에서 보고서를 확인합니다.
- 다운로드 : pdf 파일로 로컬 컴퓨터에 저장합니다.
- 공유 : 앱에서 같은 조직내에 인원에게 보고서를 공유하여 다른 팀원도 보고서를 확인할 수 있도록 합니다.
--------------------------------------------------
채팅창에서 결과를 확인합니다.

앱을 처음 구현한 것에서 현재까지 크게 3번 갱신했습니다.
첫째. 파이프라인
- 보고서의 작성 과정을 파이프라인으로 구현하여 한 단계씩 진행
- LLM을 활용하지만 대부분 파이썬 코드에서 LLM을 호출하여 진행하는 방식
둘째. 프롬프트에 파이프라인 넣기
- 지시 프롬프트를 작성하면서 파이프라인의 절차대로 LLM에서 항목을 작성하라고 지시
- 파이프라인의 파이썬 코드는 단순화 됩니다
셋째. 전체를 LLM에 일임
- 보고서 작성 요청이 들어오면 계획수립부터 최종 결과보고서까지 LLM이 구현
- 계획 수립을 하면 보고서에 필요한 항목까지 결정하여 진행
이렇게 3단계로 갱신을 하면서 어려운 점이 생겼습니다.
API 토큰 사용량이 엄청났습니다. 보고서 하나(6~8쪽 분량) 당 3$ 정도가 될만큼 토큰을 사용했습니다.
코드 분석을 하여 아래와 같이 수정했습니다.
첫 번째. LLM 호출 시 토큰 과다 사용
1. 항목은 LLM 호출(프롬프트) -> 결과(그래프, 테이블, 분석 문장)으로 작성합니다.
- 실행될 때 필요한 데이터는 쿼리 생성 툴로 DB에서 데이터셋을 가져옵니다.
- 데이터셋을 데이터프레임으로 전환하여 그래프와 테이블을 작성합니다.
2. 다음 항목을 작성할 때 이전 항목의 프롬프트와 결과가 다시 입력이 되는 구조였습니다.
3. 각 항목이 독립적으로 작성되도록 코드를 수정했습니다.
두 번째. 메타 정보
1. 메타 정보가 LLM 호출할 때마다 프롬프트에 포함됩니다.
2. 이 메타 정보를 프롬프트 캐시로 전환했습니다.
- 프롬프트 캐시 선정 : 1.25배
- 사용 시 : 0.1배
- 프롬프트 캐시는 1,000토큰 이상일 때 사용할 수 있습니다.
- 5분이 지나면 캐시 지정을 다시 해야 합니다. 보고서 작성은 5분 정도 걸리니 이 부분도 해결.
세 번째. 결론(추론모델인 오퍼스 사용)
1. 작성된 항목을 오퍼스 모델에 전달하여 결론 텍스트를 생성합니다.
- 이때 전달되는 자료가 토큰을 많이 소모합니다.
- 그래프와 테이블 : 데이터 + 기타(이미지, html 구조에 필요한 것들)
- 위의 모든 것이 전달됨으로 토큰 사용량이 많아졌습니다.
2. 오퍼스에 전달되는 것은 데이터(쿼리로 가져온 데이터셋)만 전달되면 되기에 그런 식으로 코드를 수정했습니다.
이렇게 조정하여 보고서를 작성하니 26쪽 분량의 보고서가 1.12$ 정도 되었습니다.
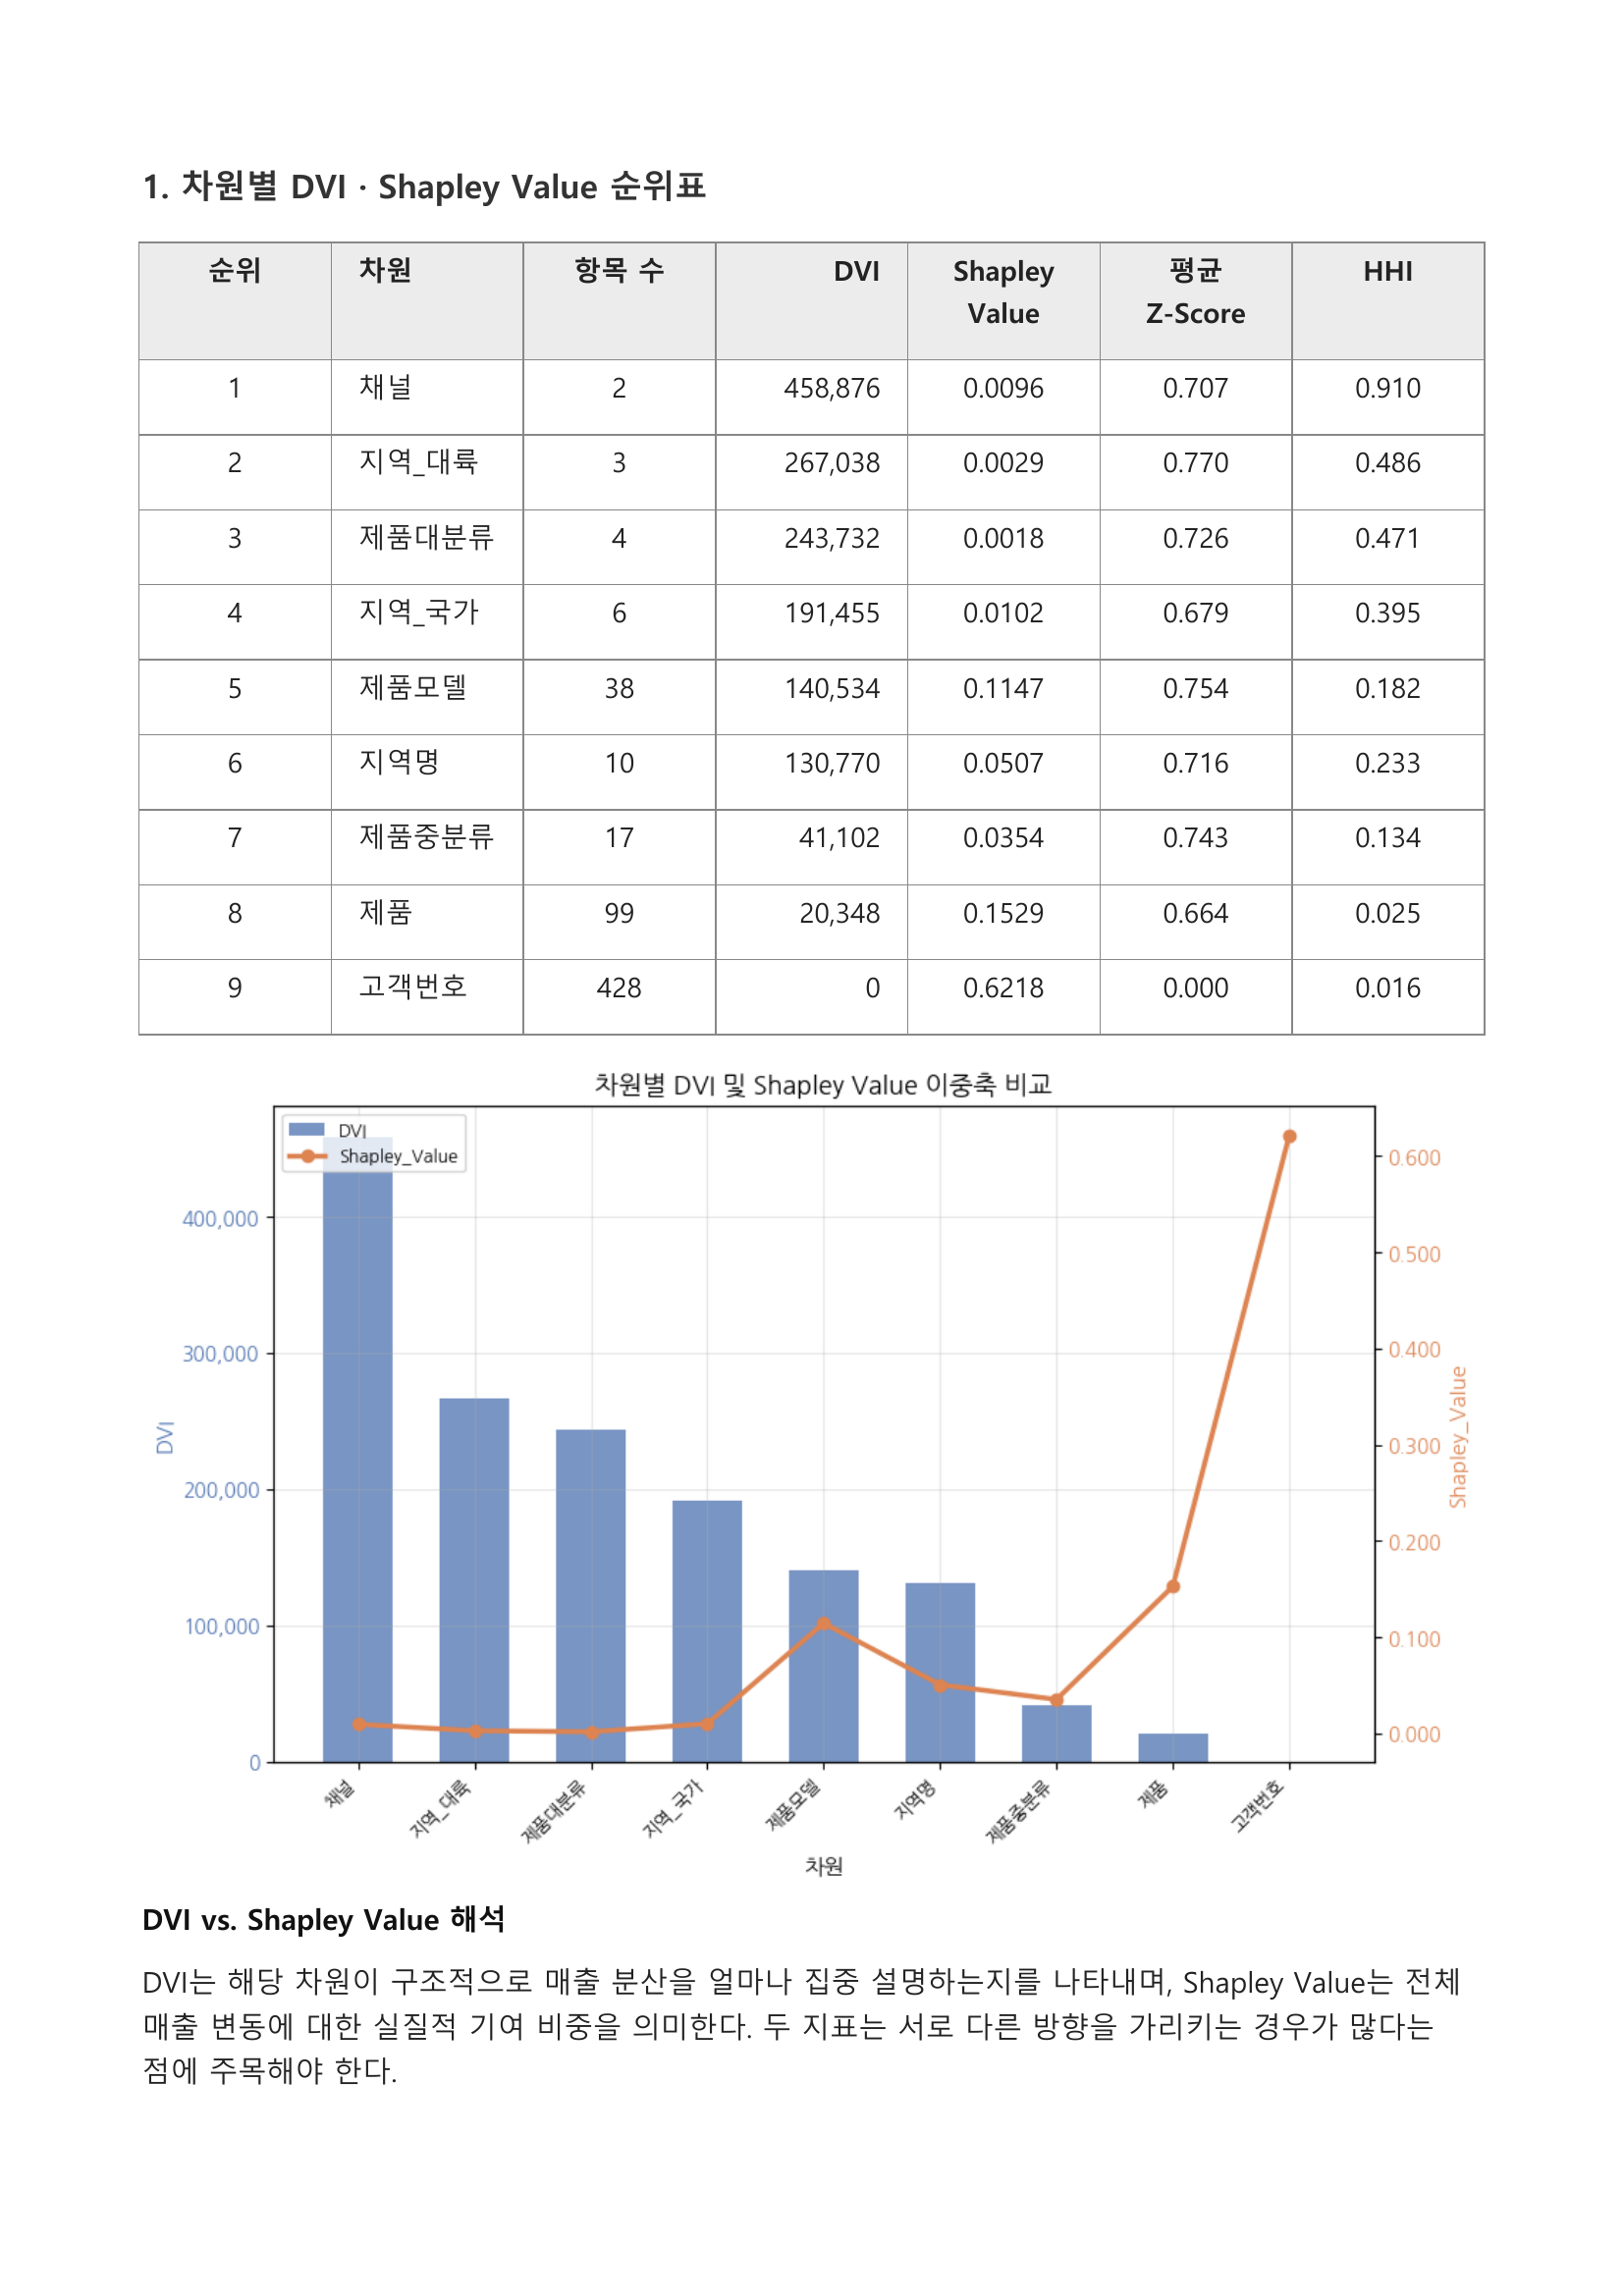
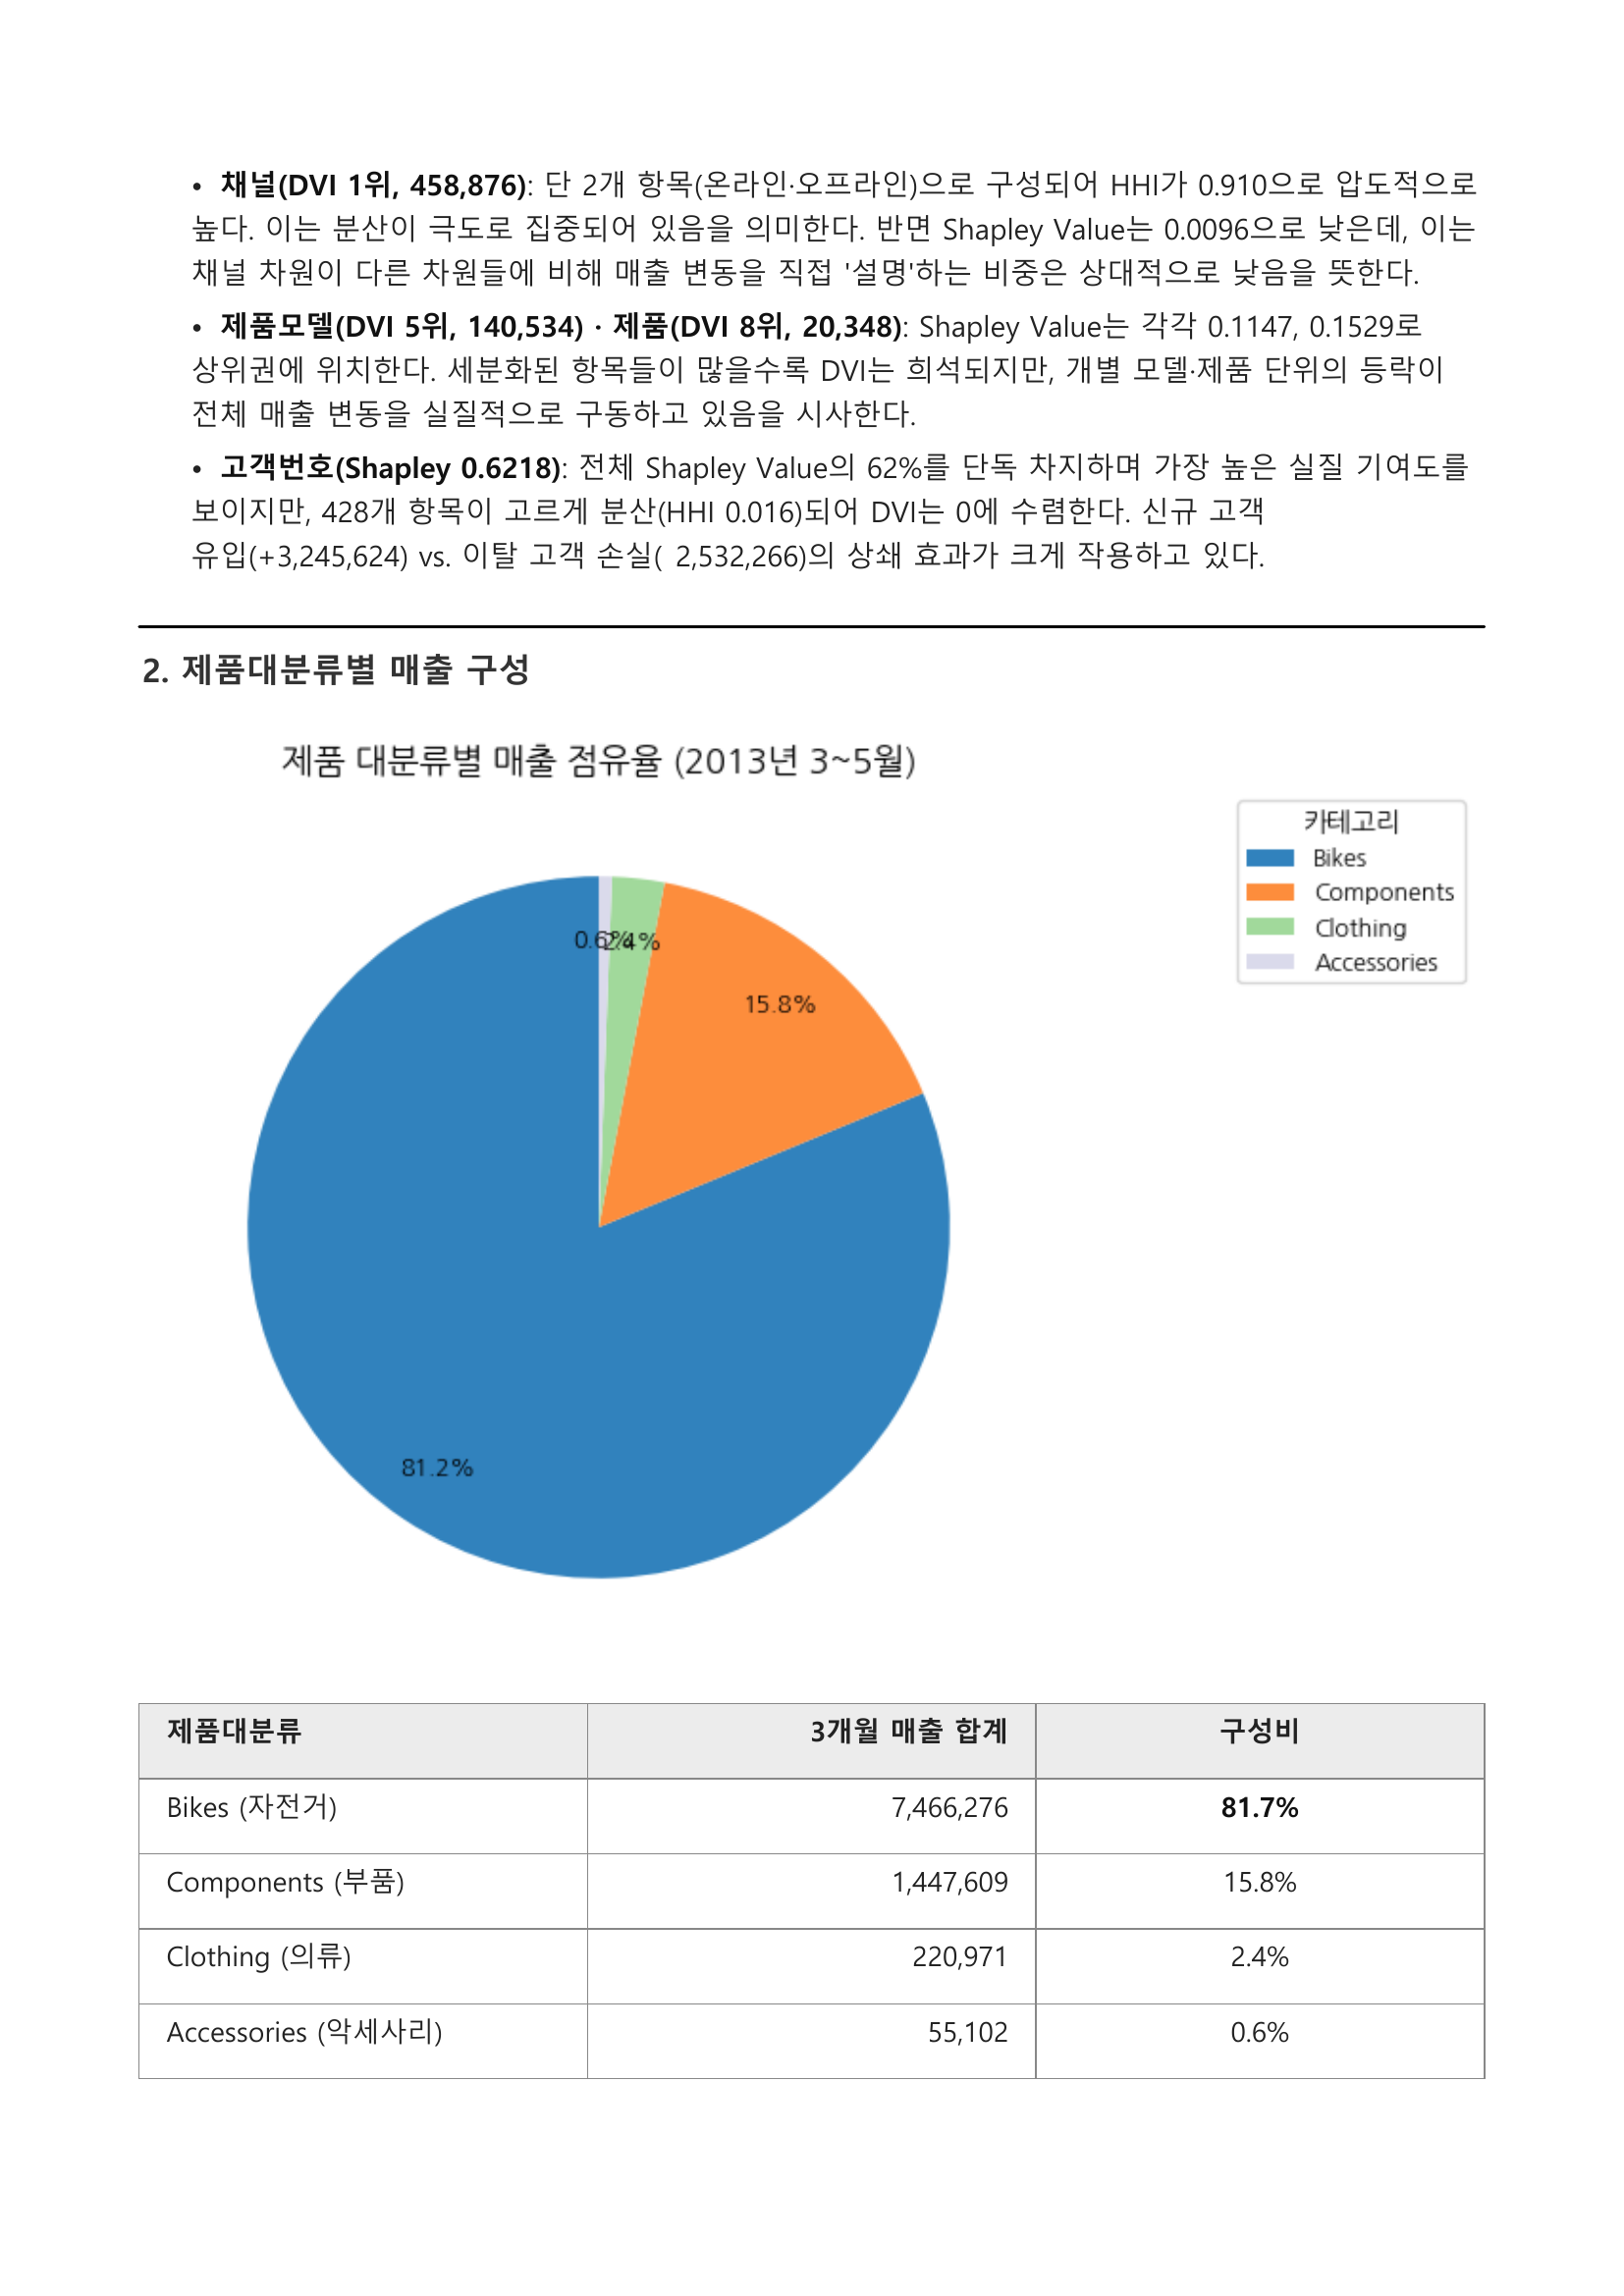
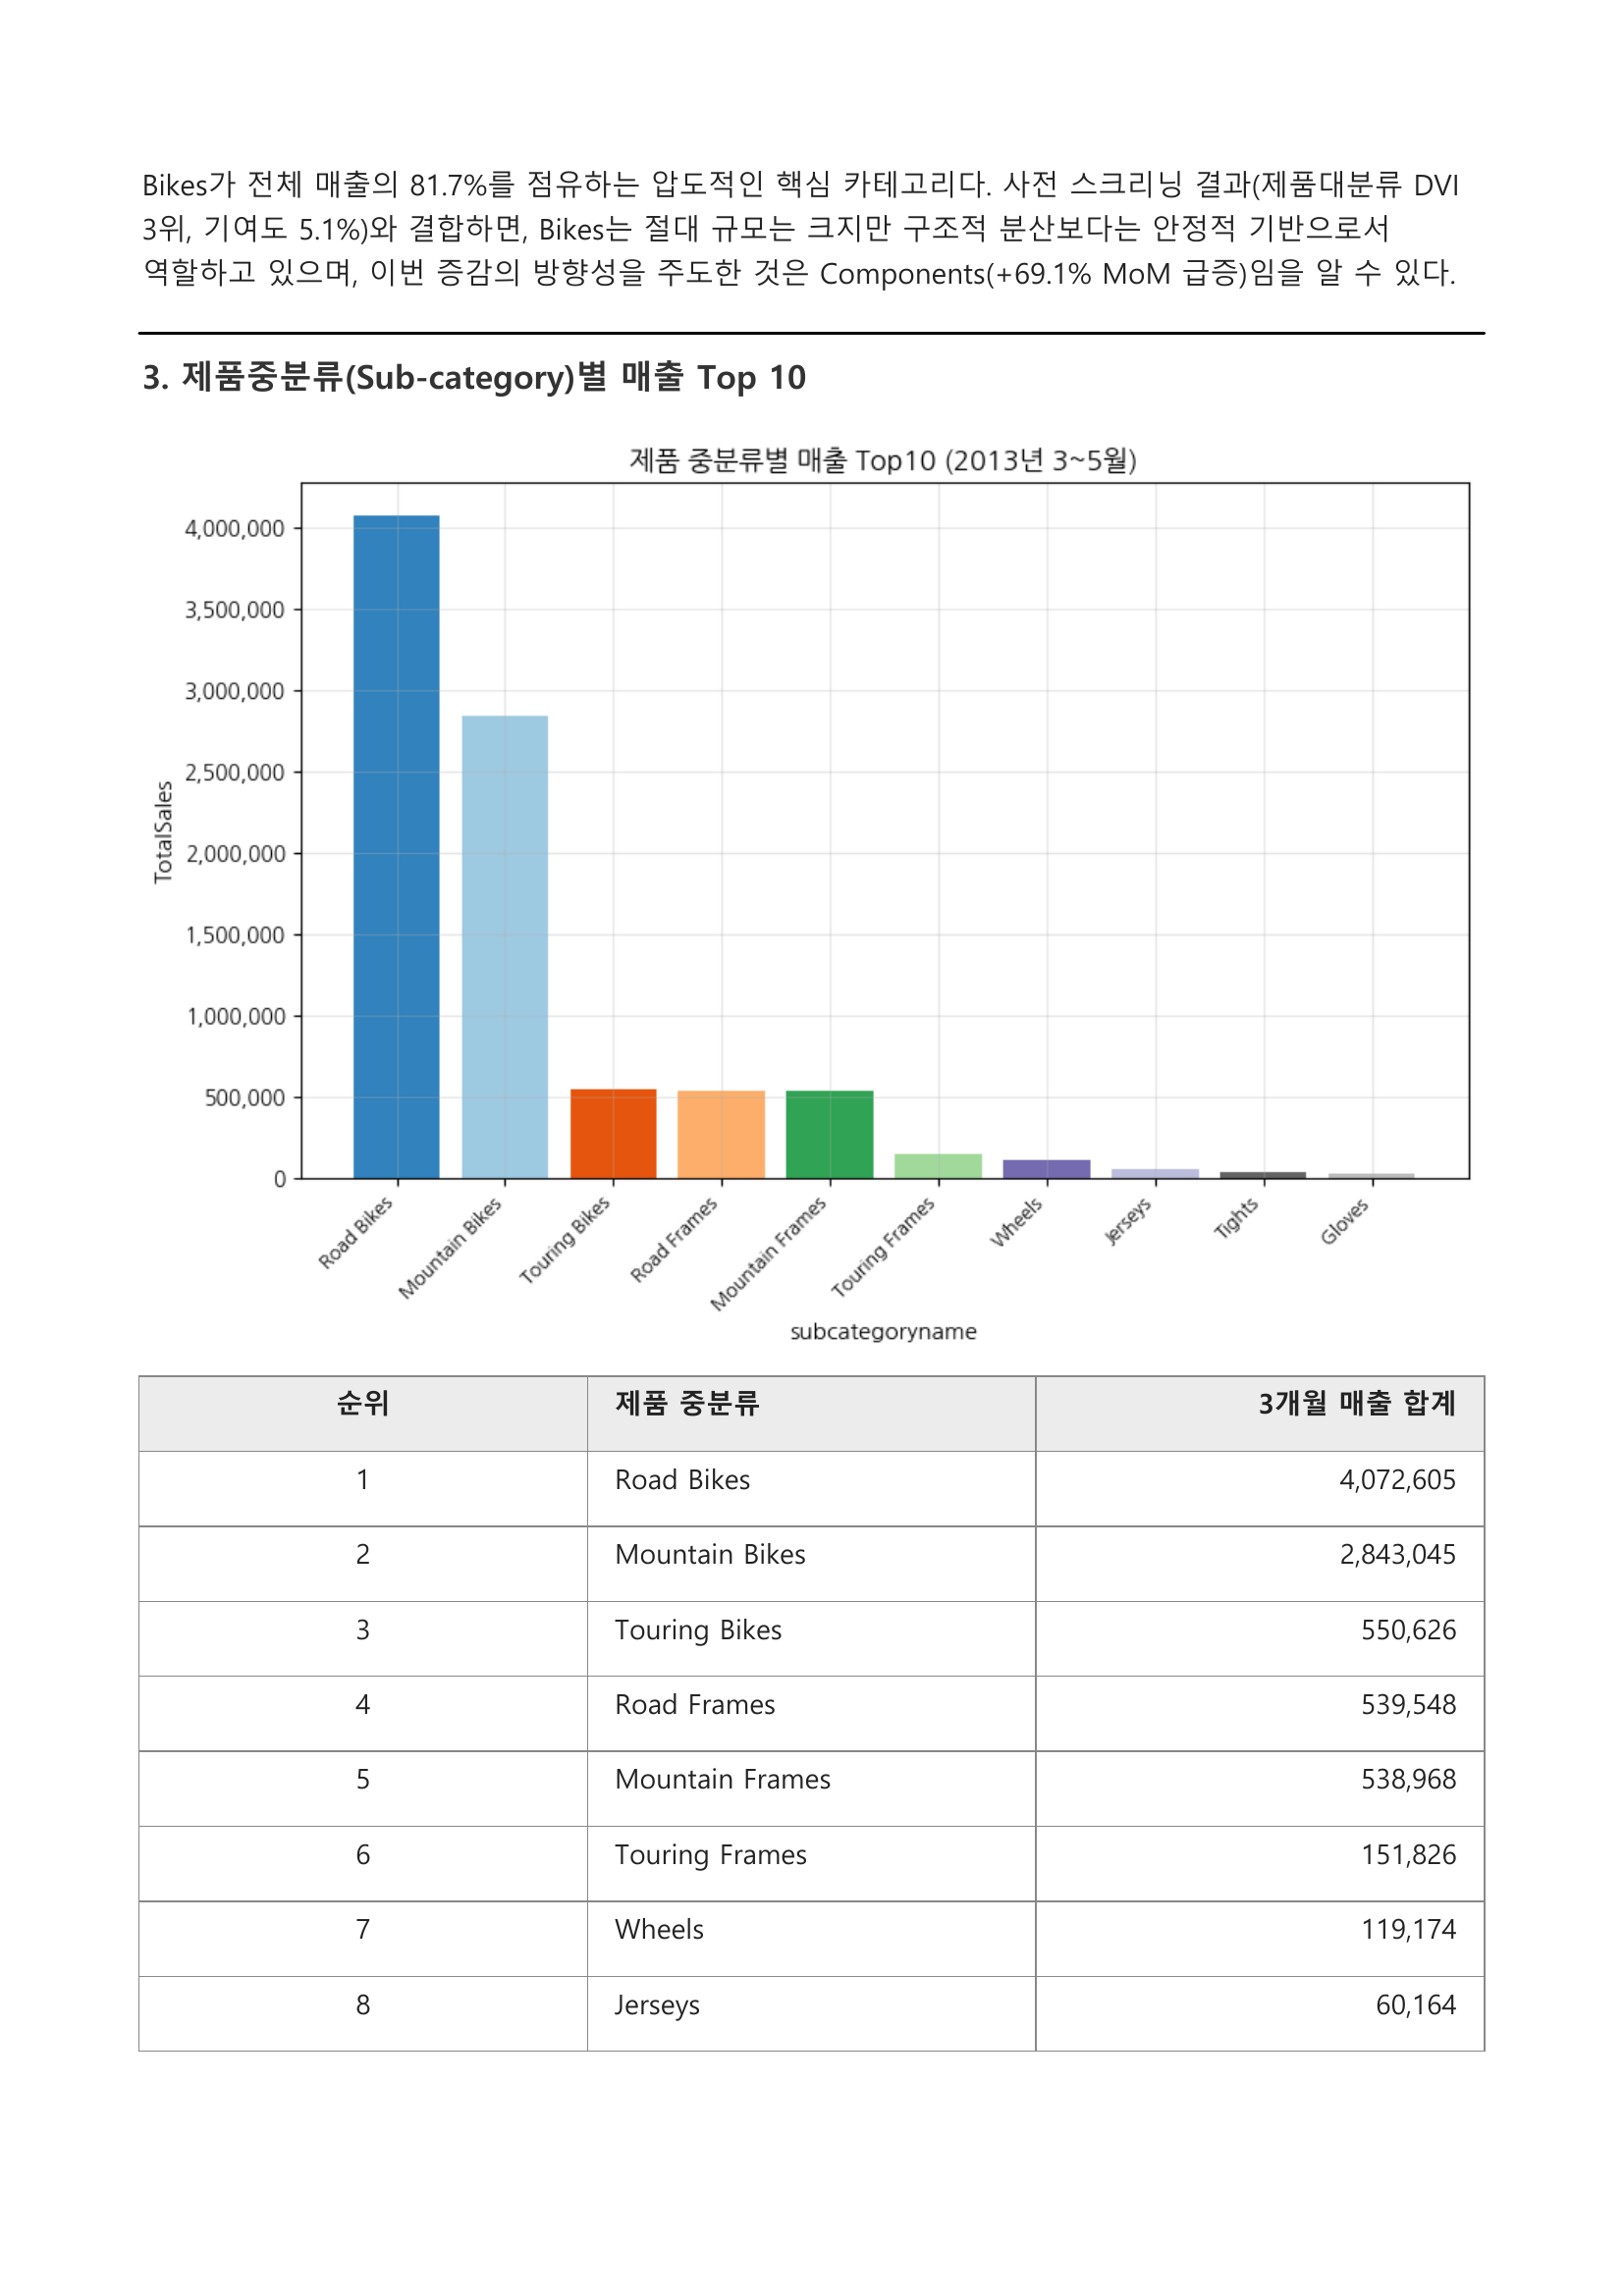
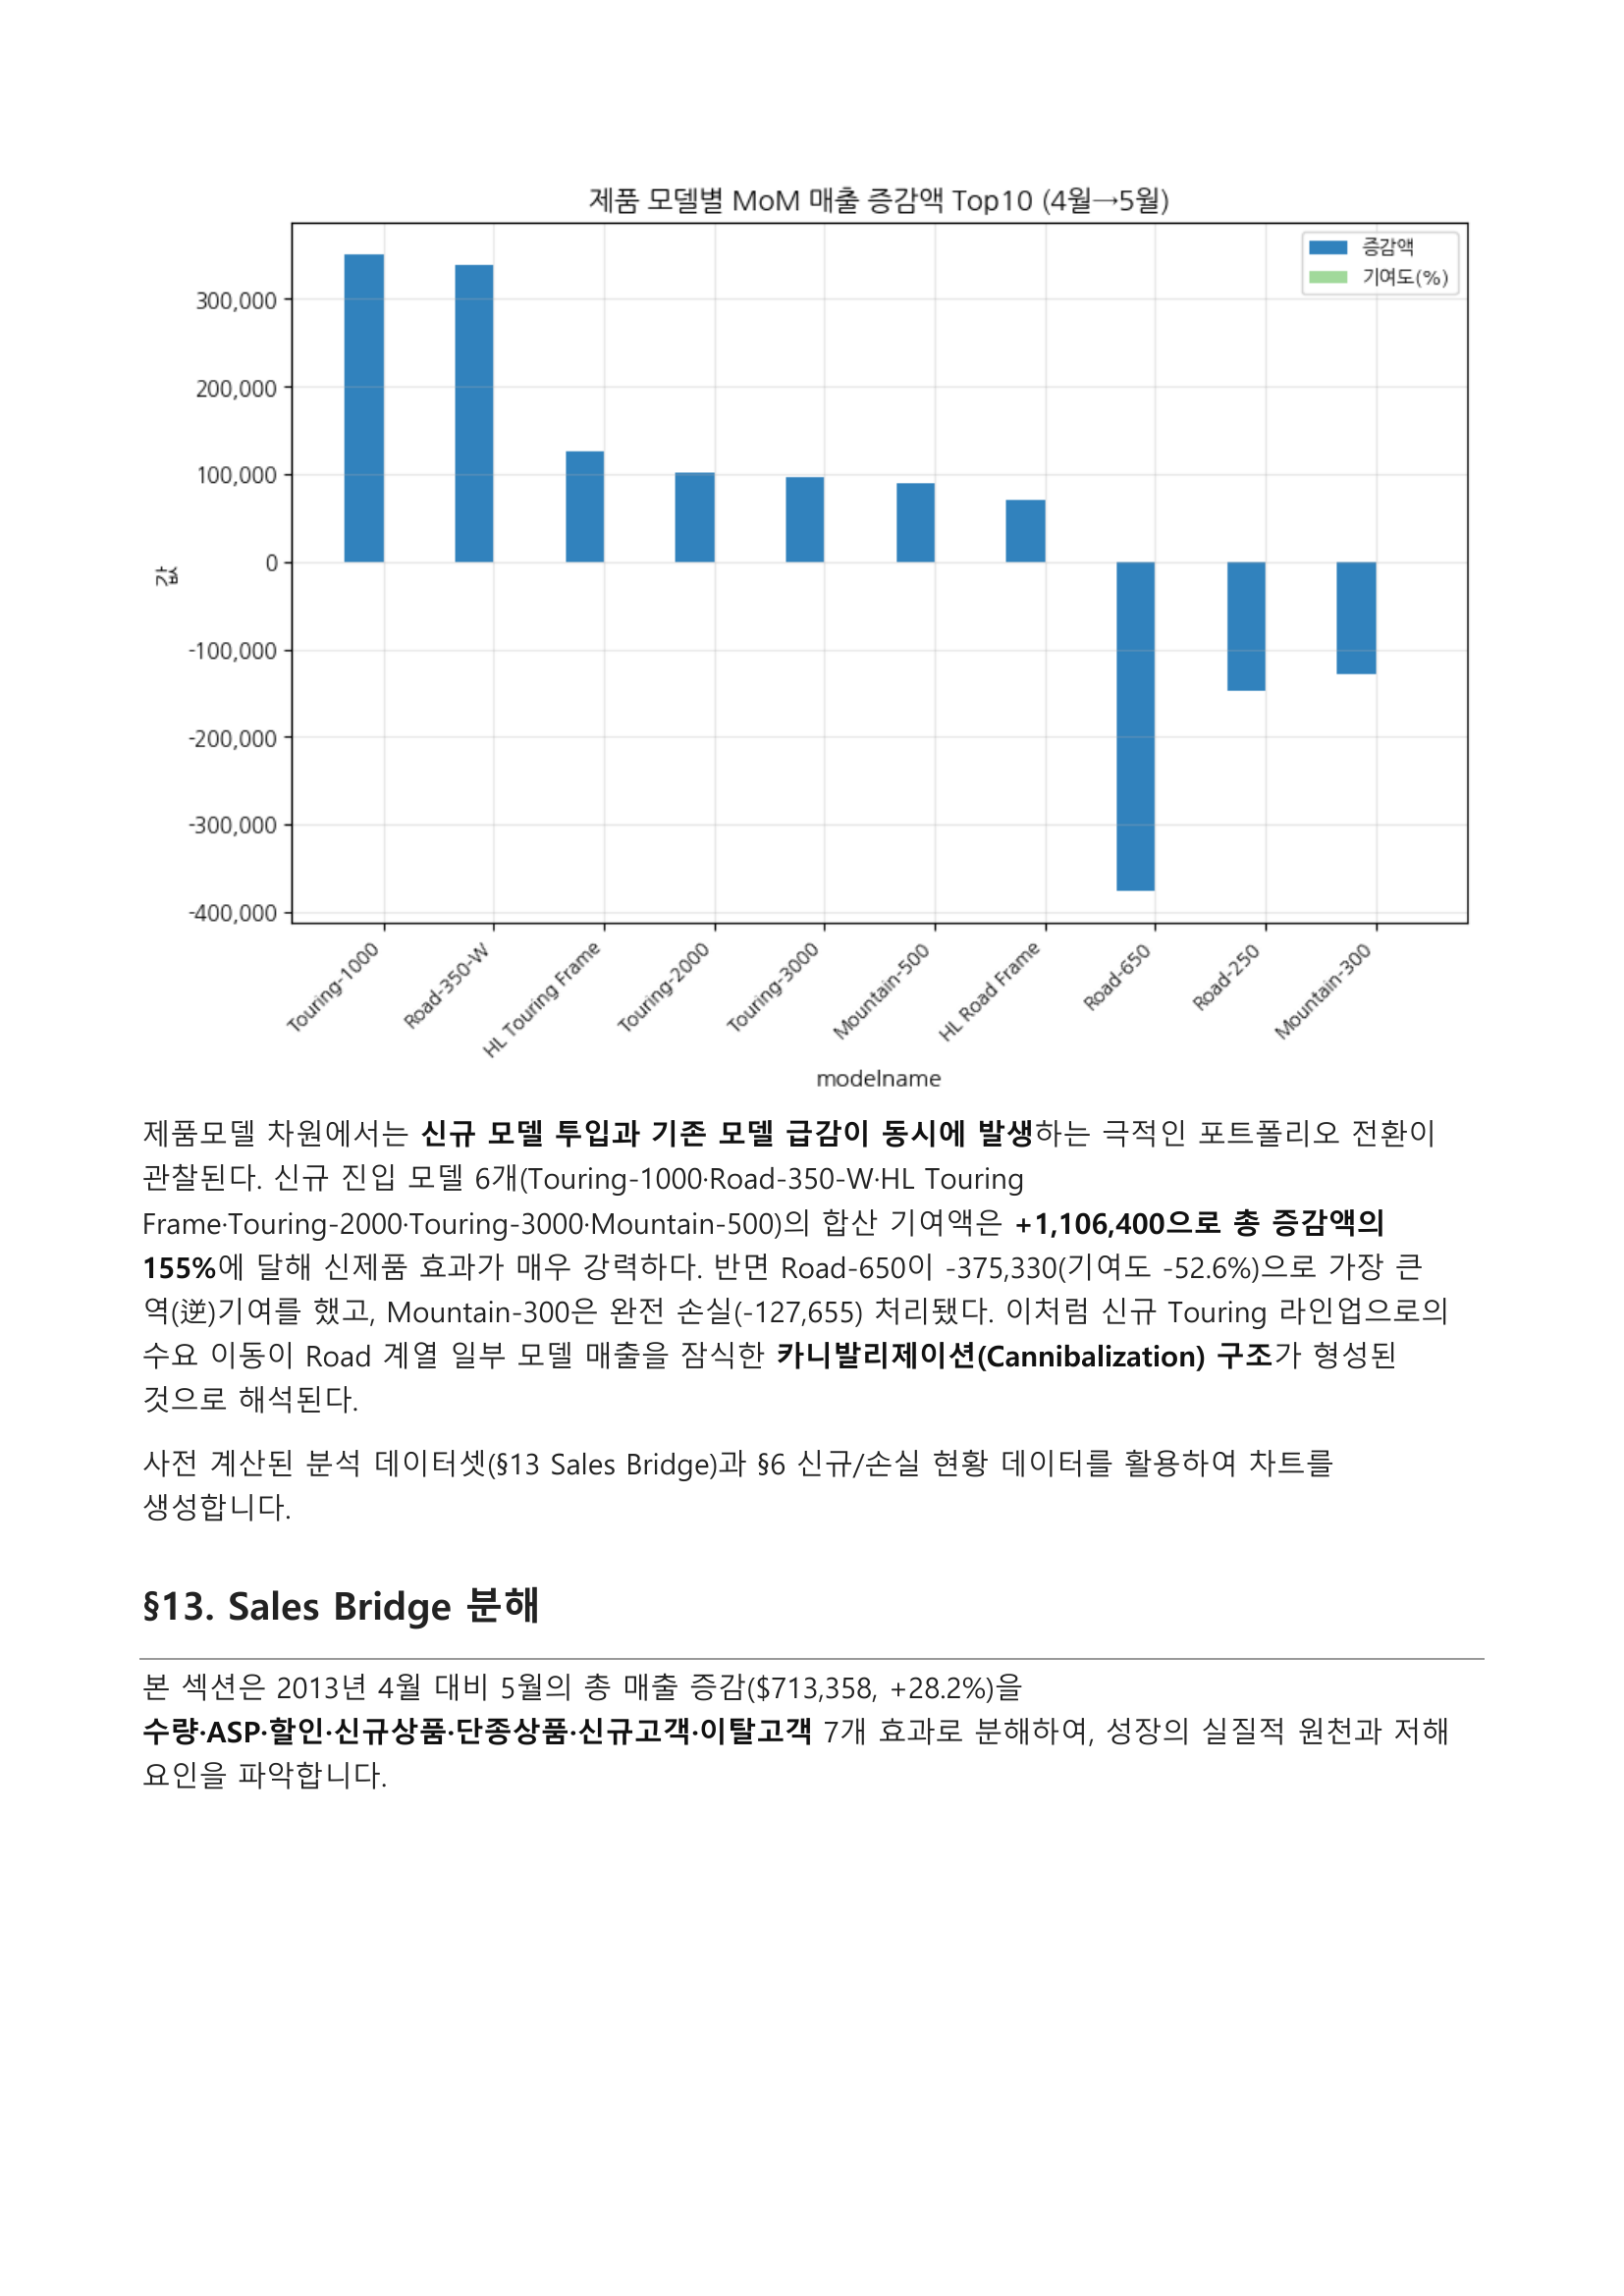
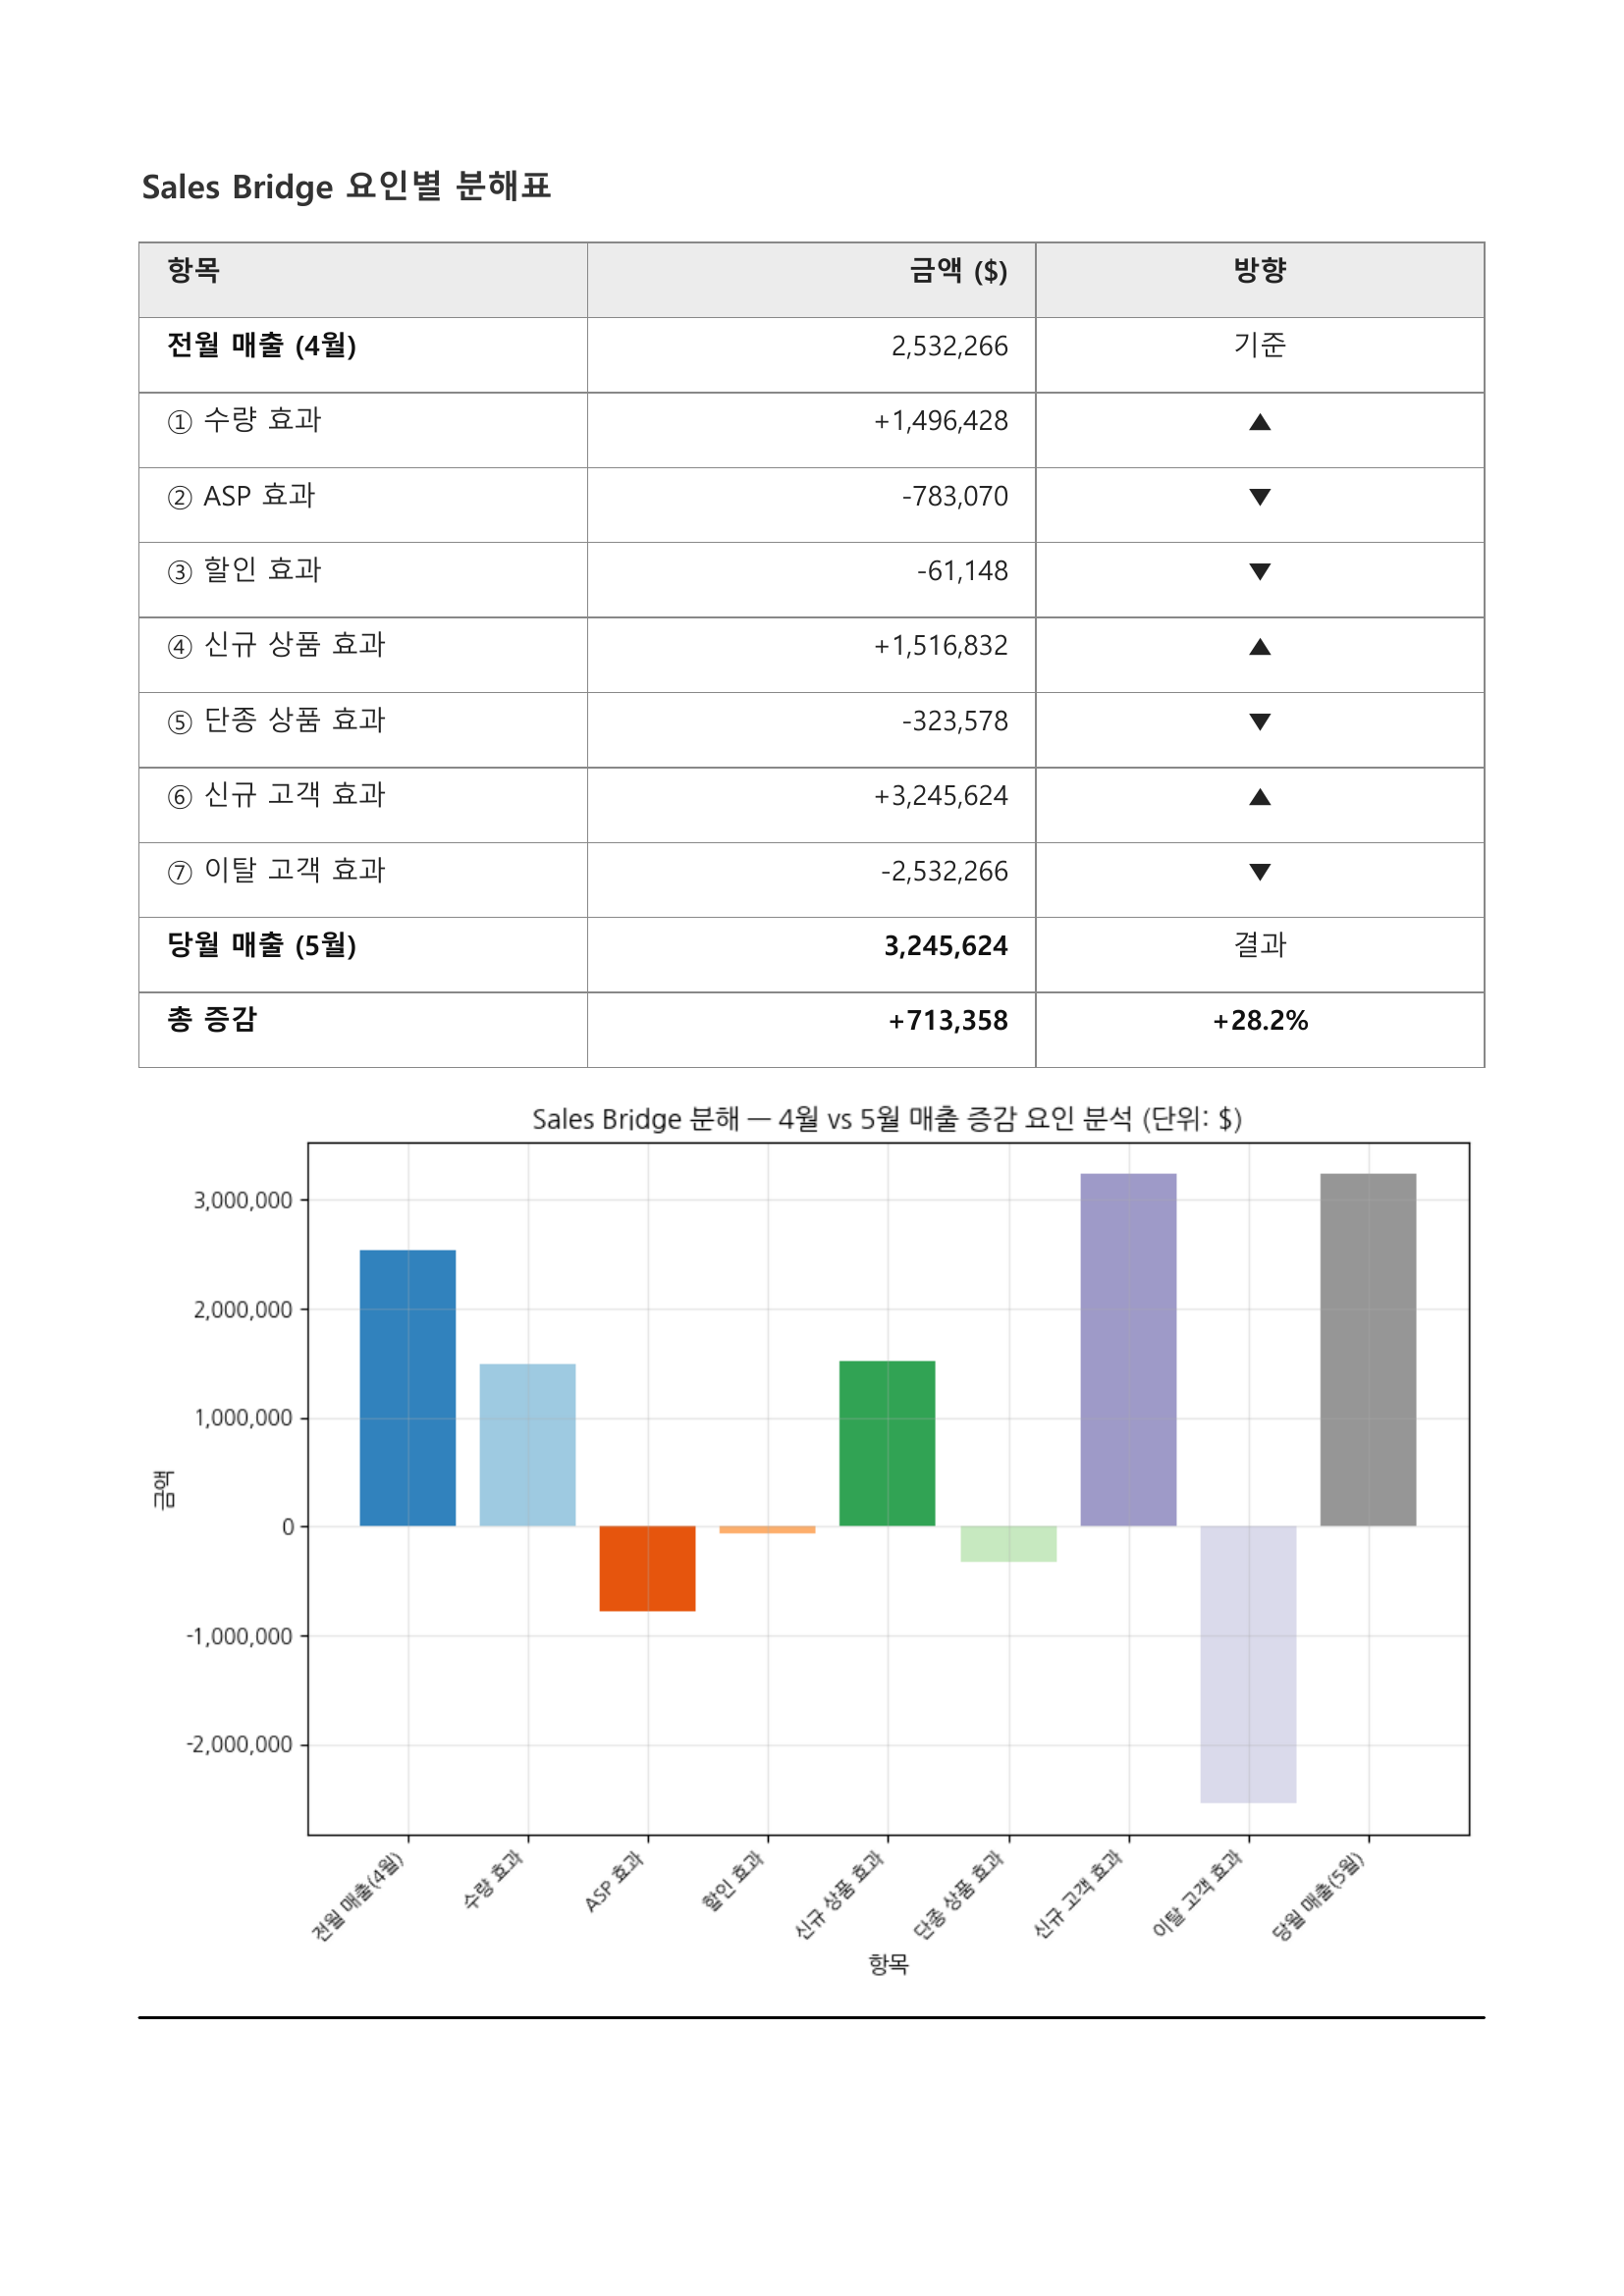
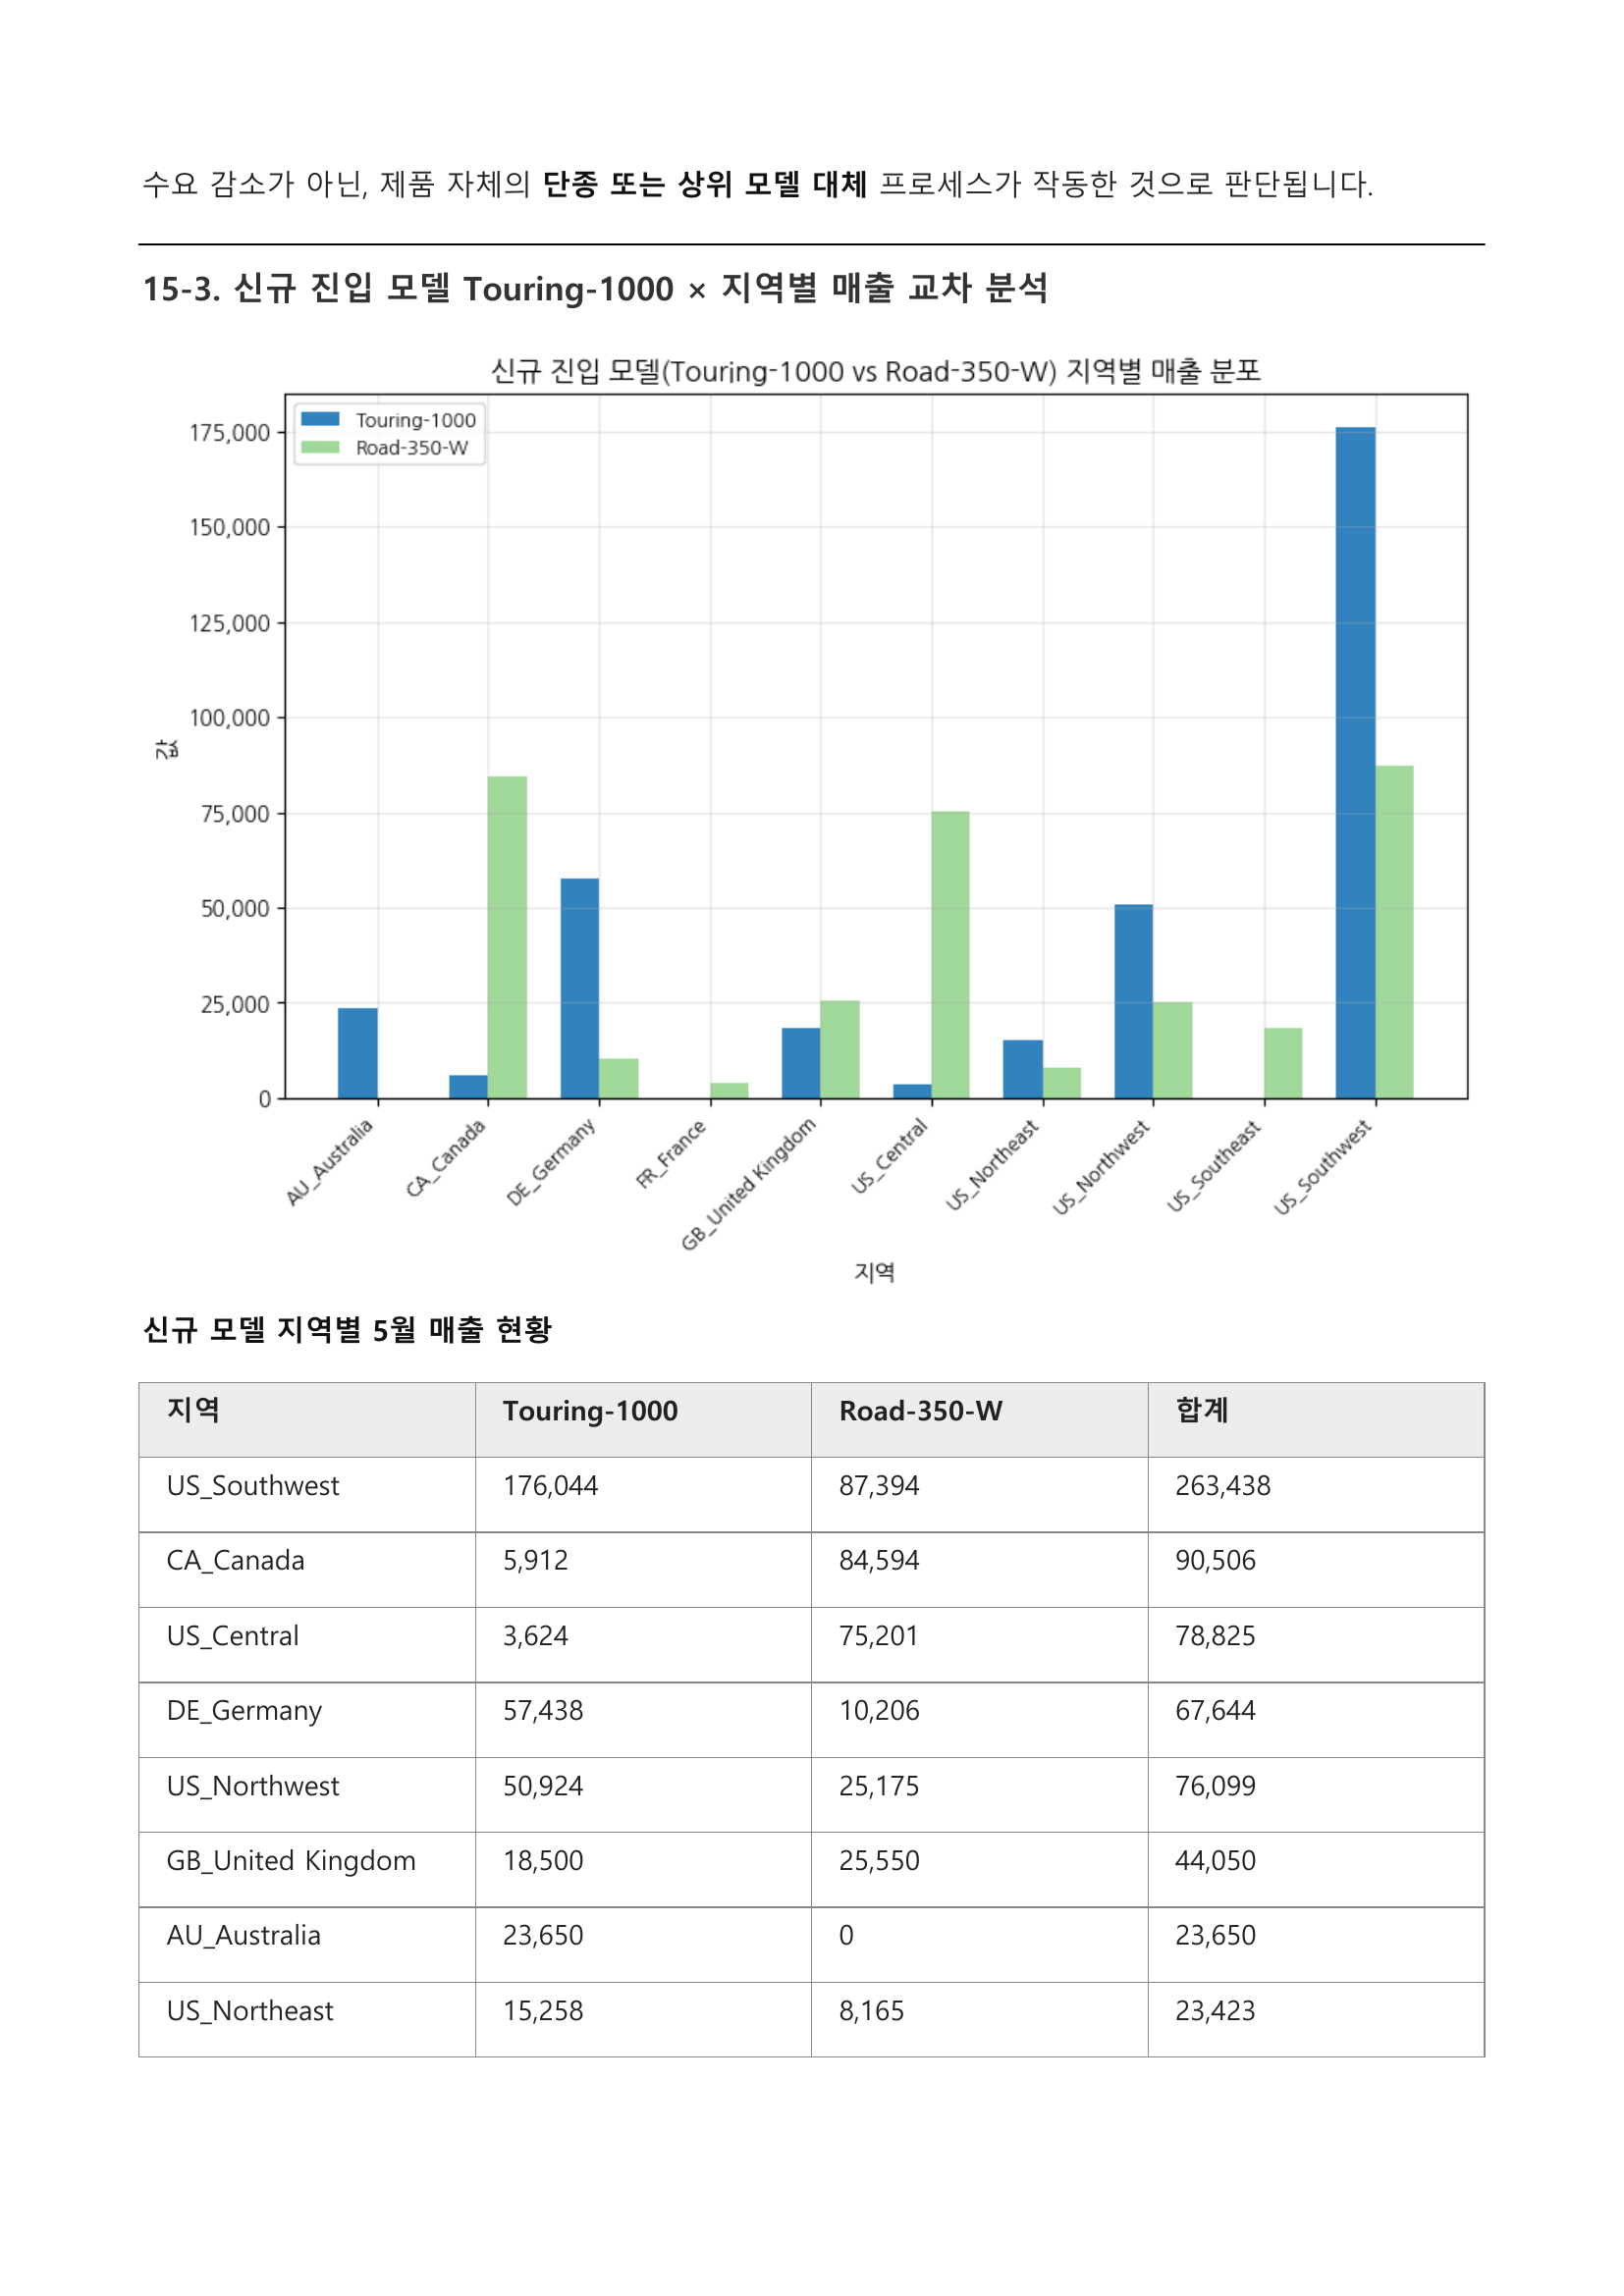
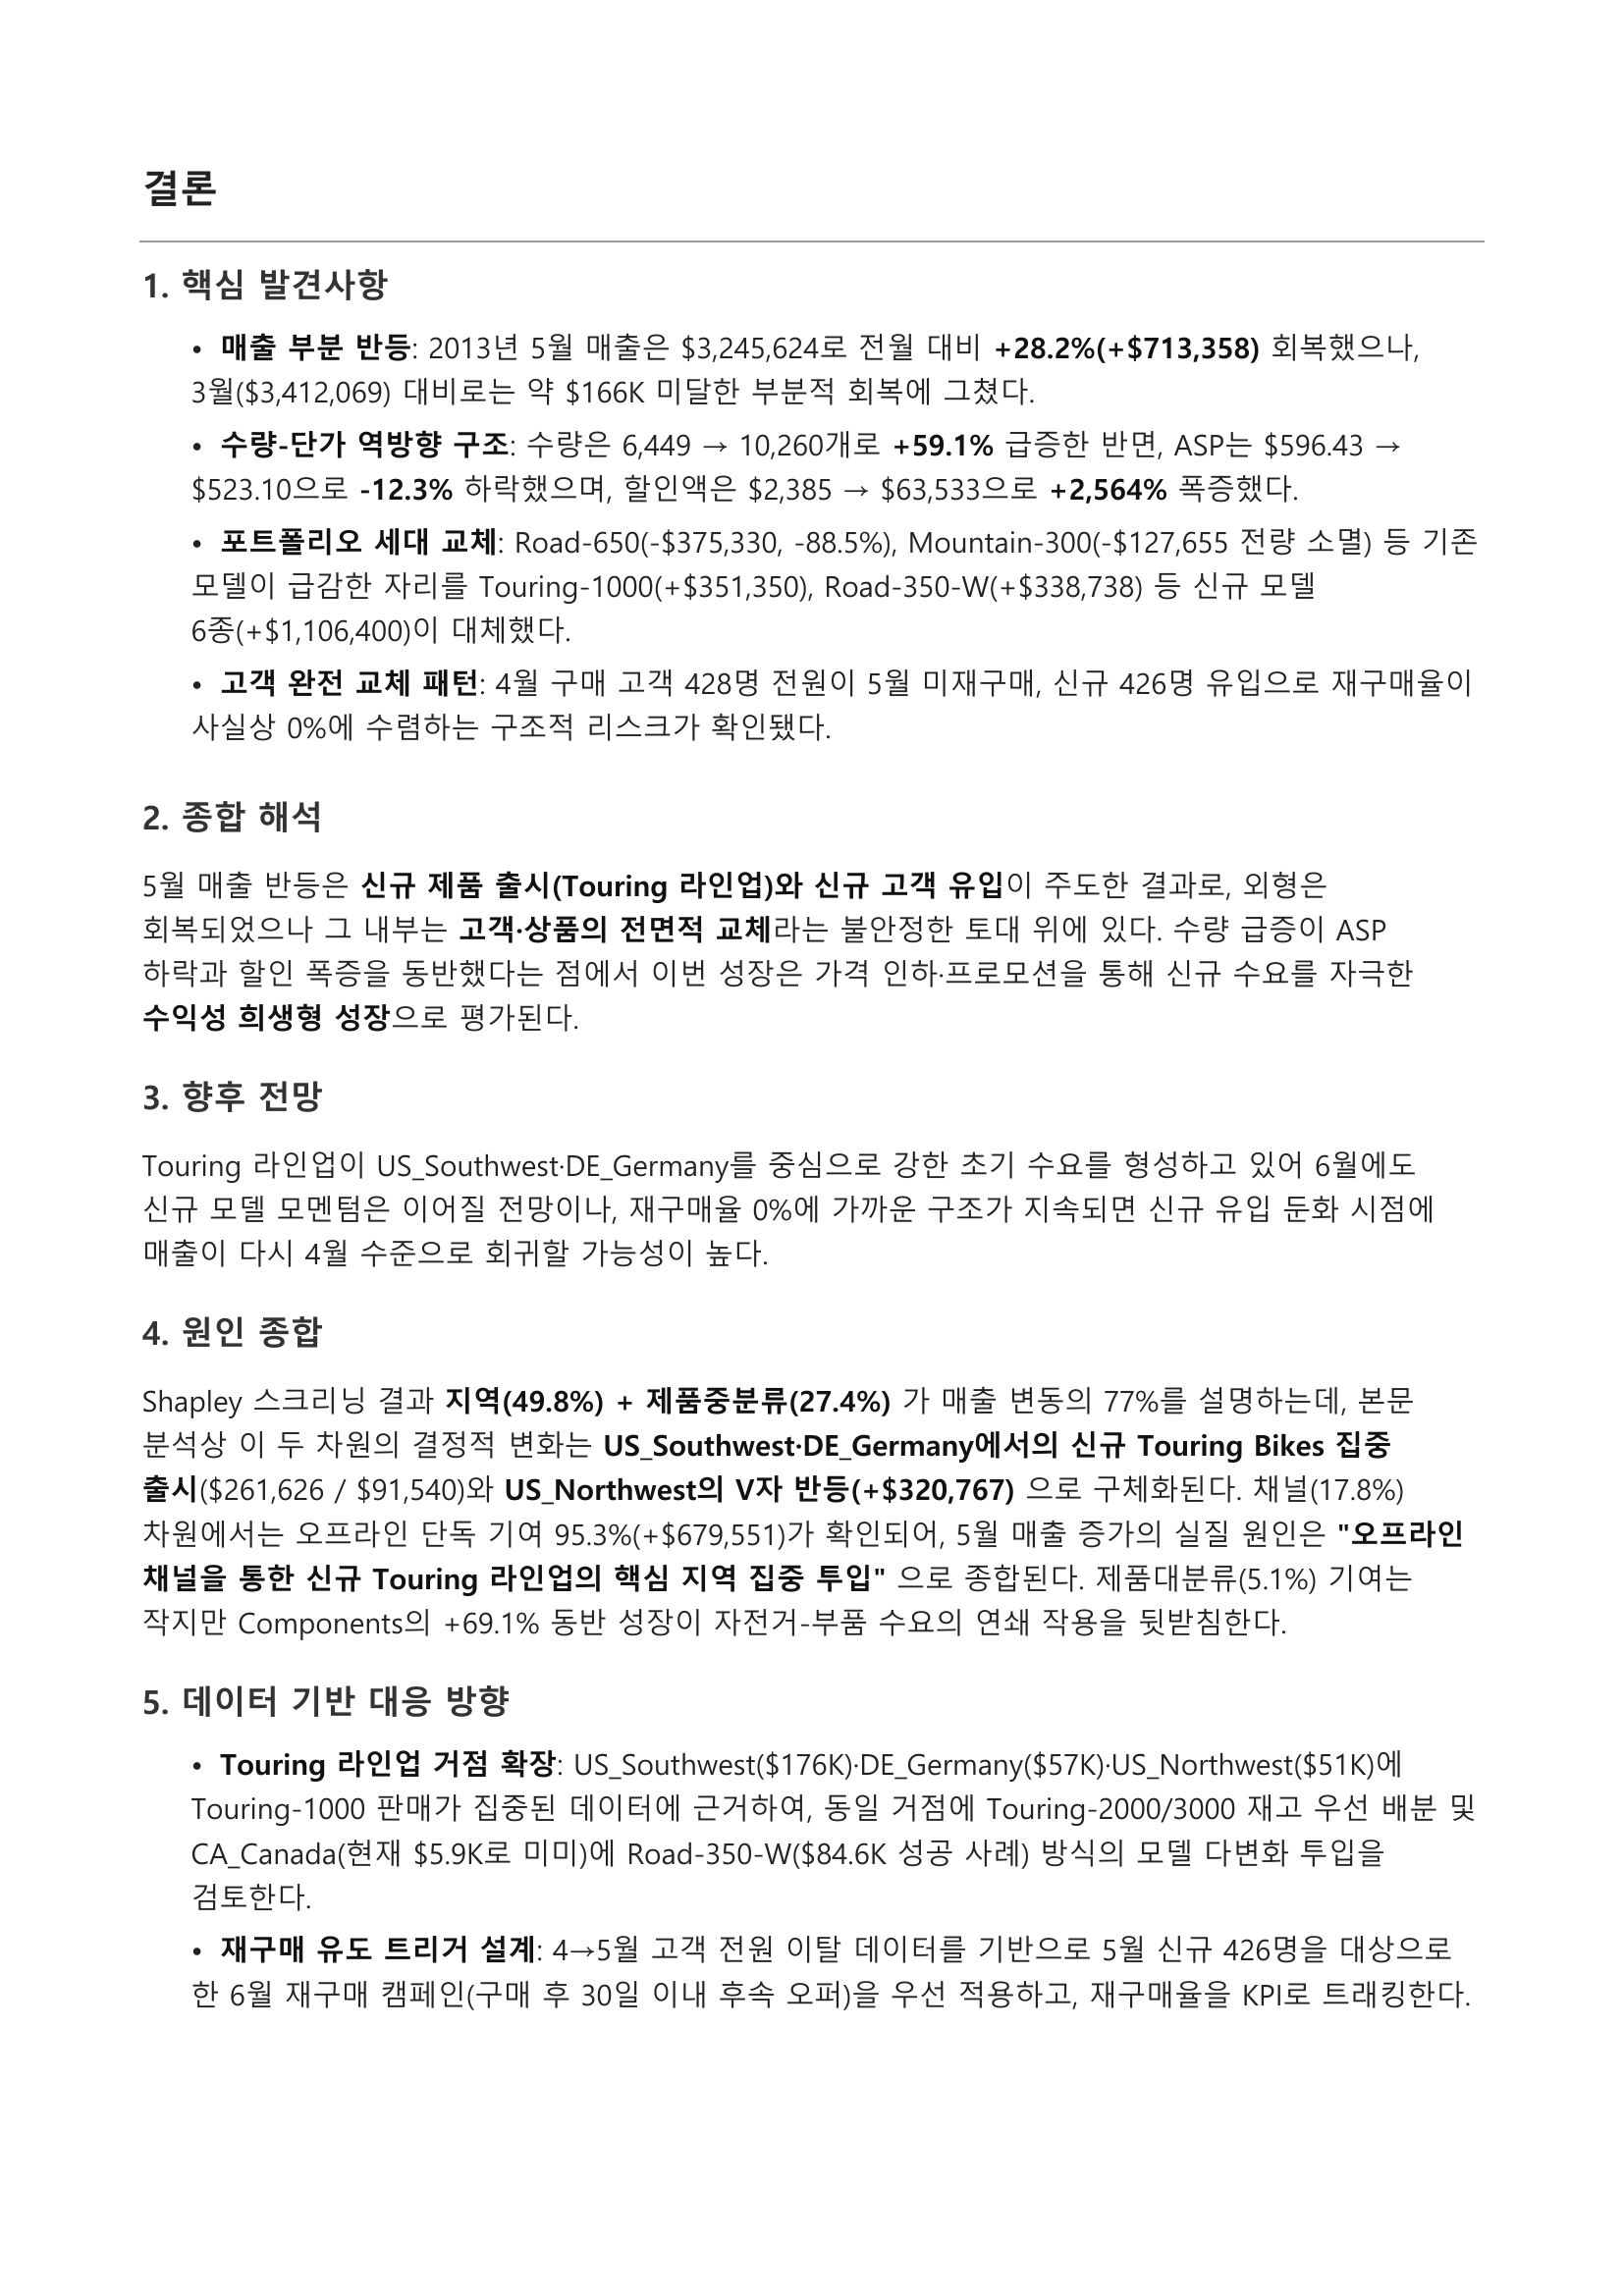
pdf로 작성된 보고서 결과 중 일부입니다.
'machineLearning > GPT' 카테고리의 다른 글
| 클로드 코드를 이용한 모델링 (0) | 2026.04.29 |
|---|---|
| Agentic Graph RAG (0) | 2026.03.30 |
| MCP 에이전트 구현 (0) | 2026.03.25 |
| OCR 판독 (0) | 2026.03.18 |
| 보고서 작성 앱 (1) | 2025.09.26 |
- Total
- Today
- Yesterday
- 고등학교 수학
- 랭체인
- RAG
- AI_고교수학
- 암석역학
- LangChain
- LLM
- Chatbot
- 미분계수
- programmers.co.kr
- 챗봇
- 미분
- prompt
- Python
- 텐서플로우
- ChatGPT
- TensorFlow
- 프로그래머스
- 도함수
- 변화율
- programmers
- 파이썬
- 약수
- FewShot
- 로피탈정리
- RockMechanics
- checkpoint
- 미분법
- streamlit
- GPT
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |